
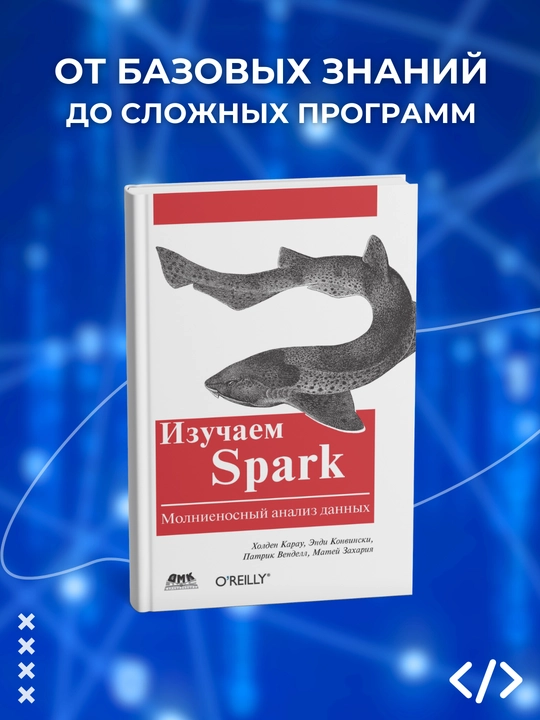
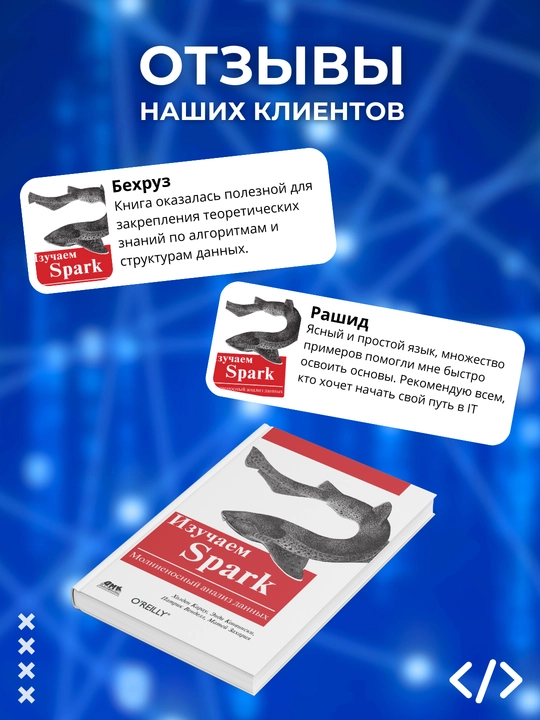
Izuchaem Spark, Molnienosniy analiz dannix, Zaxariya M., Vendell P., Konvinski E., Karau X
• Yumshoq muqova
• Qog'oz rangi: oq
• Xatcho‘p Hadya
• Sahifalar 300
• Kitobni yo'qotmaslik uchun savatga qoshib qoying📚
• Batafzil o'qing
Inson faoliyatining barcha sohalarida qayta ishlanadigan ma’lumotlar hajmi jadal sur’atlar bilan o‘sishda davom etmoqda. U bilan ishlashning samarali usullari bormi? Ushbu kitobda ma’lumotlarni tahlil qilish uchun yuqori samarali dasturlarni tezda yaratish imkonini beruvchi Apache Spark, ochiq klaster hisoblash tizimi haqida hikoya qilinadi. Spark yordamida Python, Java va Scala tillarida oddiy API yordamida katta hajmdagi ma’lumotlarni boshqarishingiz mumkin.
Spark dasturchilari tomonidan yozilgan ushbu kitob ma’lumotlar tadqiqotchilari va dasturchilarga tezda ishga kirishishga yordam beradi. U faqat bir nechta kod satrlari bilan topshiriqlarni parallel bajarishni qanday tashkil etish haqida gapiradi va oddiy paketli ilovalardan tortib, ma’lumotlar oqimini qayta ishlash va mashinaviy o‘rganish algoritmlaridan foydalanadigan dasturlargacha bo‘lgan misollarni qamrab oladi.
 26-noyabr
 Olganda qoldirish mumkin
Sotuvchi
