
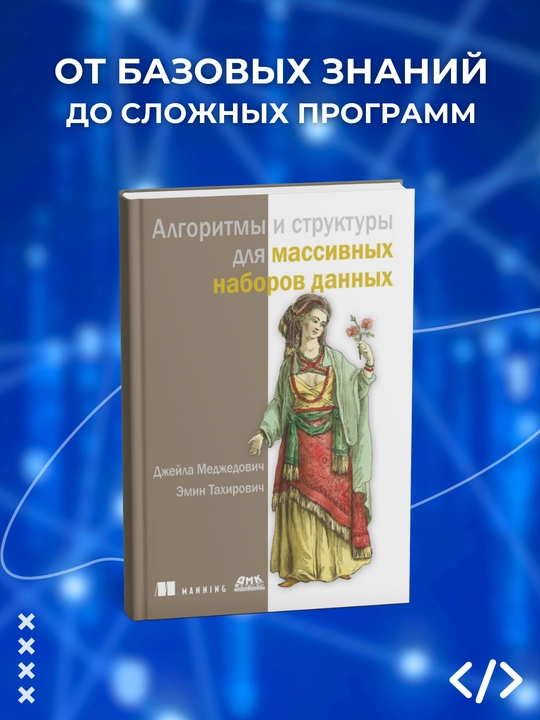
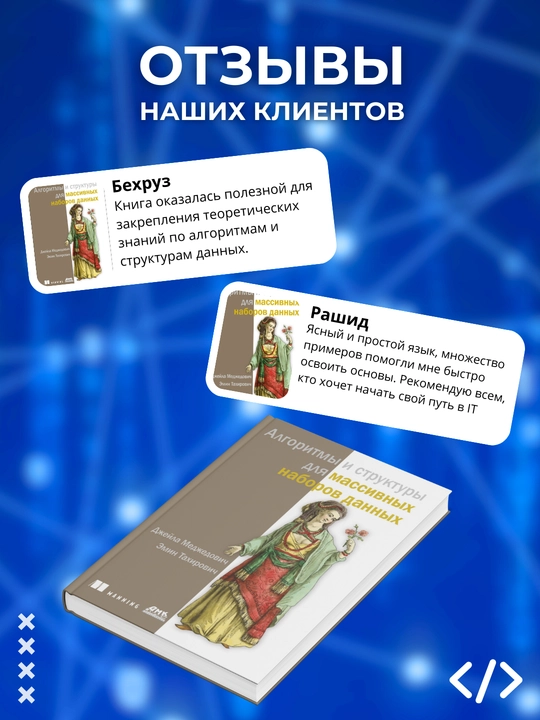
Алгоритмы и структуры для массивных наборов данных. Программирование
• Мягкий переплет
• Цвет бумаги: Белый
• Закладка в Бонус
• Количество страниц 338
• Цветные картинки
• Прочитайте полное описание
• Добавьте в корзину, чтобы не потерять книжку
Стандартные алгоритмы и структуры при применении к крупным распределенным наборам данных могут становиться медленными — или вообще не работать. Правильный подбор алгоритмов, предназначенных для работы с большими данными, экономит время, повышает точность и снижает стоимость обработки. Книга знакомит с методами обработки и анализа больших распределенных данных. Насыщенное отраслевыми историями и занимательными иллюстрациями, это удобное руководство позволяет легко понять даже сложные концепции. Вы научитесь применять на реальных примерах такие мощные алгоритмы, как фильтры Блума, набросок count-min, HyperLogLog и LSM-деревья, в своих собственных проектах.
Приведены примеры на Python, R и в псевдокоде. Основные темы:
• вероятностные структуры данных в виде набросков;
• выбор правильного движка базы данных;
• конструирование эффективных дисковых структур данных и алгоритмов;
• понимание алгоритмических компромиссов в крупно-масштабных системах;
• правильное формирование выборок из потоковых данных;
• вычисление процентилей при ограниченных пространственных ресурсах.
 20 ноября
 Можно отказаться при получении
Продавец
